
Intisari Artikel
- Data bias dan kualitas data yang buruk bisa membuat keputusan tetap salah, meski data yang tersedia sangat banyak.
- Kernel Future memperkenalkan Data Decision Framework, Keputusan Berkualitas sama dengan Kualitas Data dikalikan Kendali Bias dikalikan Disiplin Interpretasi.
- Riset McKinsey atas 1.000 investasi bisnis besar menemukan, perusahaan yang berhasil mengurangi bias dalam pengambilan keputusan mendapat return sekitar 7 persen lebih tinggi.
- Sebelum menambah lebih banyak data, periksa dulu kualitasnya lewat Data Quality Check di lima dimensi, Completeness, Accuracy, Representativeness, Consistency, dan Transparency.
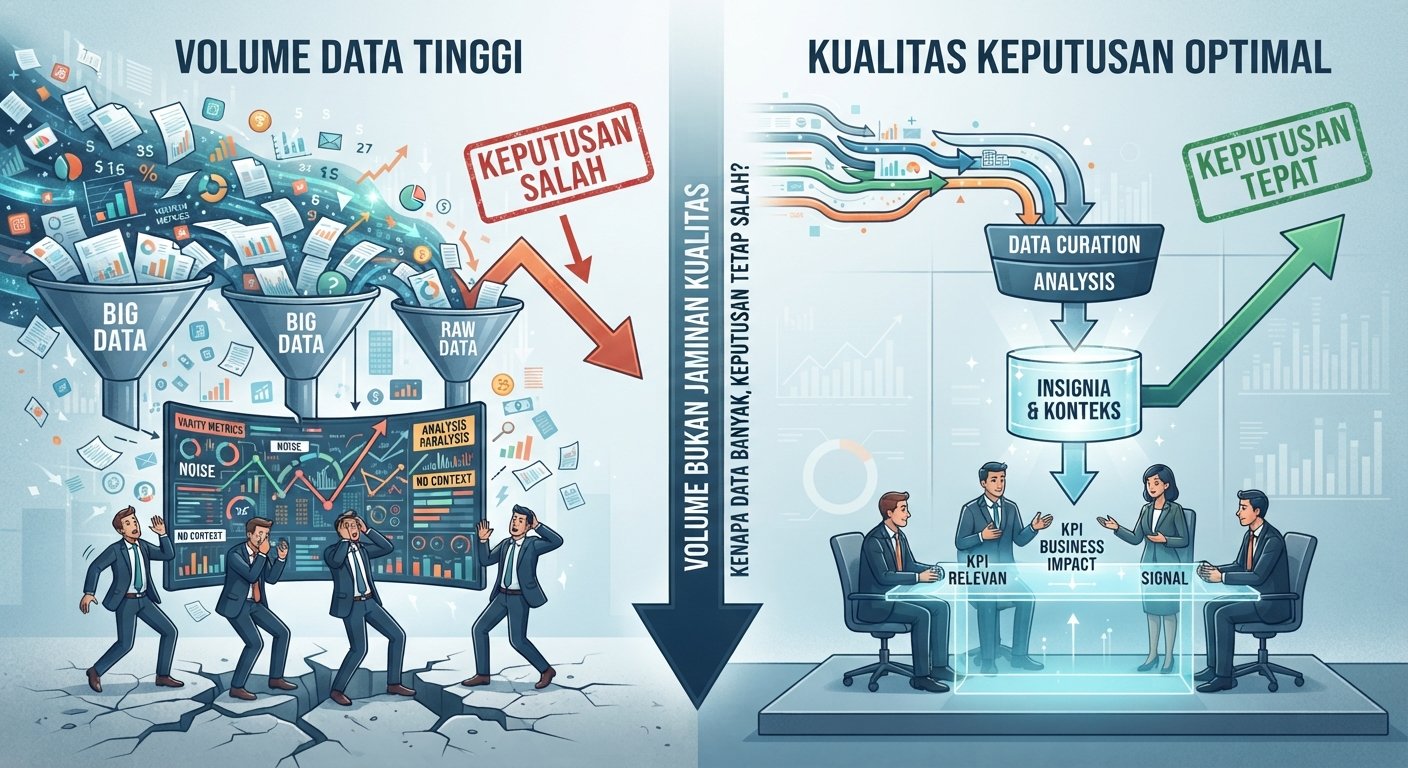
Siapa yang tidak tergoda dengan janji big data? Semakin banyak data yang dikumpulkan, semakin yakin rasanya keputusan yang diambil akan benar. Dashboard penuh angka, laporan setebal ratusan halaman, model prediksi yang terlihat canggih, semua itu memberi ilusi kepastian. Tapi tahukah Anda, kenyataannya volume data yang besar sama sekali tidak menjamin keputusan yang lebih baik?
Kernel Future ingin meluruskan satu hal sejak awal. Masalahnya bukan karena data yang dipakai perusahaan kurang banyak. Masalahnya adalah karena data yang banyak itu tidak pernah diperiksa kualitas dan biasnya sebelum dipakai mengambil keputusan. Data banyak keputusan tetap salah, kalau fondasinya sendiri sudah rapuh sejak awal.
Kenapa Data Banyak Tidak Otomatis Berarti Keputusan Lebih Baik?
Riset akademik yang membedah risiko big data menemukan sesuatu yang berlawanan dengan intuisi kebanyakan orang, yaitu apa yang disebut information bias. Ini adalah keyakinan keliru bahwa semakin banyak informasi, semakin baik keputusan yang dihasilkan. Padahal dalam banyak kasus, data yang berlebihan justru memperbesar noise dan kesalahan, sehingga aturan sederhana kadang menghasilkan keputusan yang lebih baik dibanding analisis yang rumit atas tumpukan data yang bias.
Ini masuk akal kalau dipikir ulang. Data yang banyak tapi kotor hanya melipatgandakan kesalahan, bukan menguranginya. Pertanyaannya bukan lagi seberapa besar data yang dimiliki perusahaan, melainkan seberapa bersih dan representatif data tersebut sebelum jadi dasar keputusan penting.
Kernel Future Data Decision Framework
Untuk menjawab persoalan itu, Kernel Future melihat kualitas keputusan sebagai hasil dari tiga variabel yang saling bergantung, bukan sekadar fungsi dari besarnya volume data.
Keputusan Berkualitas = Kualitas Data × Kendali Bias × Disiplin Interpretasi
Kualitas Data Seberapa lengkap, akurat, konsisten, dan transparan data tersebut, terlepas dari seberapa besar volumenya.
Kendali Bias Seberapa sadar organisasi terhadap bias yang mungkin bersembunyi dalam proses pengumpulan, seleksi, dan pelaporan data.
Disiplin Interpretasi Seberapa disiplin tim dalam menahan diri dari kesimpulan berlebihan, tidak asal menambah data tanpa memeriksa relevansinya terhadap pertanyaan yang sedang dijawab.
Karena ketiganya berbentuk perkalian, data yang melimpah tidak akan menyelamatkan keputusan kalau kualitasnya buruk, biasnya tidak terkendali, atau interpretasinya serampangan. Tiga bagian berikutnya membedah masing masing variabel ini secara lebih dalam.
Deep Dive 1, Kualitas Data yang Sering Diabaikan
Data banyak tidak ada artinya kalau kualitasnya sendiri bermasalah, dan masalah ini jauh lebih umum dari yang dibayangkan kebanyakan pengambil keputusan.
Riset dari Grace Liu, pustakawan bisnis di West Chester University, yang meninjau hampir lima puluh tahun literatur bisnis dan keuangan atas database besar seperti CRSP dan Compustat, mengidentifikasi sebelas kategori masalah kualitas data yang paling umum ditemukan, mencakup nilai yang hilang, kesalahan data, ketidaksesuaian antar sumber, bias tersembunyi, inkonsistensi definisi, data header yang statis, masalah standardisasi, perubahan data historis, kurangnya transparansi, masalah waktu pelaporan, dan penyalahgunaan data. Riset ini menemukan bahwa database yang paling banyak dipakai peneliti dan analis keuangan sekalipun, tetap menyimpan kesalahan yang bisa mengubah kesimpulan sebuah analisis secara signifikan.
Kernel Future Insight Fakta bahwa database sekelas Compustat dan CRSP saja, yang dipakai puluhan ribu riset akademik dan analisis keuangan profesional, masih menyimpan sebelas kategori masalah kualitas data, seharusnya jadi peringatan keras. Kalau database sebesar dan seprofesional itu saja tidak bebas masalah, data internal perusahaan Anda yang dikumpulkan lebih informal kemungkinan besar menyimpan masalah yang jauh lebih banyak, hanya belum pernah diperiksa secara sistematis.
Deep Dive 2, Bias yang Bersembunyi di Balik Angka
Data yang terlihat objektif sering kali membawa bias yang tidak terlihat, dan bias ini bisa mengubah arah keputusan tanpa disadari siapa pun yang membacanya.
Inclusion Cloud menjelaskan bahwa data governance menjadi kunci mengatasi bias data, karena kalau perusahaan memberi makan sistem analitik atau AI mereka dengan data berkualitas rendah, insight yang dihasilkan ikut cacat dan berujung pada keputusan yang salah arah serta peluang yang terlewat. Toucan Toco menambahkan penjelasan yang lebih tajam, bias bisa membuat bisnis buta terhadap peluang pasar yang sebenarnya ada, karena kebutuhan pelanggan yang beragam tidak pernah terekam dalam sampel data yang dipakai.
Dampaknya bisa menjalar jauh ke ranah kebijakan sosial. World Journal of Advanced Research and Reviews mencatat bahwa model penilaian kredit yang dilatih dengan data yang kurang mewakili kelompok demografis atau wilayah geografis tertentu, berpotensi secara sistematis merugikan kelompok minoritas atau berpenghasilan rendah. Pola serupa juga ditemukan di industri asuransi, di mana data historis yang mengandung praktik diskriminatif masa lalu bisa membuat premi tetap lebih mahal untuk kelompok tertentu, meskipun profil risiko mereka saat ini sudah tidak lagi mendukung perbedaan itu.
Kernel Future Insight Bias data bukan cuma soal akurasi teknis, ini soal siapa yang diuntungkan dan siapa yang dirugikan oleh keputusan yang lahir dari data tersebut. Kalau perusahaan Anda memakai data historis untuk memutuskan siapa yang layak dapat kredit, harga asuransi, atau bahkan siapa yang layak direkrut, tanpa pernah memeriksa dari kelompok mana data itu berasal, keputusan itu berisiko mengulang ketimpangan yang sama persis dengan masa lalu, hanya dibungkus dengan angka yang terlihat objektif.
Deep Dive 3, Ironi Big Data, Ketika Lebih Banyak Justru Lebih Buruk
Semakin banyak data yang dianalisis, semakin besar pula ruang munculnya korelasi palsu yang kebetulan terlihat signifikan secara statistik, padahal sebenarnya tidak berarti apa apa.
Riset yang membedah risiko big data untuk pembangunan manusia menjelaskan bahwa ketika terlalu banyak hipotesis diuji sekaligus atas satu kumpulan data, sebagian hasil yang tampak signifikan secara statistik sebenarnya cuma kebetulan belaka, sebuah fenomena yang dikenal sebagai data dredging. Semakin besar dan semakin banyak dimensi datanya, semakin sulit pula teknik statistik standar bekerja efektif, sehingga jumlah temuan palsu justru tumbuh lebih cepat dibanding sinyal yang benar benar berguna.
Untungnya, riset lain menunjukkan jalan keluarnya bukan menambah lebih banyak data, melainkan mendisiplinkan proses pengambilan keputusan itu sendiri. Dan Lovallo dan Olivier Sibony, dalam riset yang diterbitkan McKinsey Quarterly, menganalisis lebih dari 1.000 investasi bisnis besar dan menemukan bahwa perusahaan yang secara sadar bekerja mengurangi bias dalam proses pengambilan keputusan strategis mereka, mencatat return atas investasi sekitar tujuh poin persentase lebih tinggi dibanding yang tidak melakukannya.
Kernel Future Insight Angka tujuh persen ini penting karena menunjukkan sesuatu yang kontraintuitif, perbaikan return terbesar datang bukan dari menambah lebih banyak data atau model yang lebih canggih, melainkan dari mendisiplinkan cara manusia menginterpretasikan data yang sudah ada. Perusahaan yang terus menerus menambah dashboard dan sumber data baru tanpa pernah membenahi proses pengambilan keputusannya, kemungkinan besar sedang menambah biaya tanpa menambah kualitas keputusan sama sekali.
Framework Second Order Impact, dari Data Bias ke Ketimpangan Nyata
Bagian ini menunjukkan bagaimana bias dalam data yang terlihat sepele bisa merambat jadi konsekuensi yang jauh lebih besar dari yang dibayangkan siapa pun di ruang rapat.
First Order Impact Data terkumpul dalam jumlah besar. Dashboard terlihat kaya insight, laporan penuh angka, semua terlihat meyakinkan di atas kertas.
↓
Second Order Impact Keputusan mulai diambil berdasarkan pola dalam data tersebut, tanpa pernah memeriksa dari kelompok mana data itu berasal, seberapa representatif sampelnya, atau bias apa yang mungkin terkandung di dalam proses pengumpulannya.
↓
Third Order Impact Konsekuensi sosial dan ekonomi mulai muncul, biasanya baru terlihat setelah pola itu berulang cukup lama, dalam bentuk,
- Discriminatory outcomes, kredit dan asuransi secara sistematis merugikan kelompok tertentu karena data historis yang dipakai mewarisi bias masa lalu
- Missed opportunities, bisnis buta terhadap peluang pasar baru karena data yang dipakai tidak pernah mencerminkan kebutuhan pelanggan yang lebih beragam
- False confidence, tim merasa yakin dengan keputusan yang sebenarnya dibangun di atas korelasi palsu hasil data dredging
- Trust erosion, kepercayaan pelanggan dan publik runtuh ketika bias dalam keputusan perusahaan akhirnya terungkap ke permukaan
↓
Business Impact Value creation atau value destruction. Perusahaan yang disiplin memeriksa kualitas dan bias datanya mendapat return yang lebih tinggi seperti temuan McKinsey di atas. Perusahaan yang terus menumpuk data tanpa disiplin yang sama, cepat atau lambat akan membayar mahal lewat keputusan yang salah arah, reputasi yang rusak, dan kepercayaan yang sulit dipulihkan.
Data Quality Check
Setelah memahami masalahnya, langkah berikutnya adalah menilai kualitas data yang sedang Anda pakai untuk mengambil keputusan. Kernel Future menggunakan lima pertanyaan berikut, dirangkum dari kategori masalah kualitas data yang paling sering ditemukan. Jawab setiap pertanyaan dengan Ya atau Belum, lalu hitung total jawaban Ya di akhir.
Completeness Apakah data yang dipakai bebas dari nilai yang hilang dalam jumlah signifikan, terutama pada variabel yang paling menentukan keputusan? (Ya / Belum)
Accuracy Apakah data sudah diverifikasi silang dengan sumber lain untuk memastikan bebas dari kesalahan input atau kesalahan perhitungan? (Ya / Belum)
Representativeness Apakah sampel data mencerminkan populasi yang sebenarnya ingin dipahami, bukan hanya kelompok yang paling mudah diakses atau paling banyak tercatat? (Ya / Belum)
Consistency Apakah definisi dan cara pengkodean data konsisten sepanjang waktu dan antar sumber, tidak berubah diam diam di tengah jalan? (Ya / Belum)
Transparency Apakah jelas dari mana data ini berasal, bagaimana ia dikumpulkan, dan siapa yang bertanggung jawab atas kualitasnya? (Ya / Belum)
Hasil 0 sampai 2 jawaban Ya, artinya data Anda Belum Layak Pakai untuk keputusan penting dan perlu dibenahi dulu fondasinya. 3 sampai 4 jawaban Ya, artinya data Anda Perlu Verifikasi Tambahan sebelum benar benar diandalkan untuk keputusan besar. 5 jawaban Ya, artinya data Anda Siap Jadi Dasar Keputusan strategis dengan tingkat kepercayaan yang wajar.
Kalau hasil Anda belum sampai lima, itu artinya menambah lebih banyak data justru berisiko memperbesar kesalahan yang sama, bukan memperbaikinya.
Pertanyaan yang Sering Diajukan (FAQ)
Apakah data yang lebih banyak selalu menghasilkan keputusan yang lebih baik?
Tidak selalu. Riset tentang risiko big data menunjukkan adanya information bias, keyakinan keliru bahwa lebih banyak informasi selalu berarti keputusan lebih baik, padahal data yang berlebihan dan bias justru bisa memperbesar kesalahan, bukan menguranginya.
Apa penyebab utama data banyak tapi keputusan tetap salah?
Penyebab utamanya adalah kualitas data yang tidak diperiksa dan bias yang tersembunyi dalam proses pengumpulan serta pelaporan data, bukan kurangnya volume data. Riset atas database bisnis dan finansial besar menemukan sebelas kategori masalah kualitas data yang umum ditemukan bahkan di database yang paling banyak dipakai profesional.
Bagaimana bias data bisa memperburuk ketimpangan ekonomi?
Ketika data historis yang bias dipakai untuk model kredit atau asuransi, kelompok yang secara historis dirugikan bisa terus menerus dirugikan oleh keputusan otomatis yang tampak objektif, sehingga pola ketimpangan lama terulang dalam bentuk angka yang terlihat netral.
Apa cara paling efektif memperbaiki kualitas keputusan berbasis data
Riset McKinsey Quarterly menemukan bahwa mendisiplinkan proses pengambilan keputusan untuk mengurangi bias memberi dampak lebih besar dibanding menambah lebih banyak data, dengan return yang lebih tinggi sekitar tujuh poin persentase pada perusahaan yang melakukannya secara konsisten.
Sebelum bertanya berapa banyak data yang kami butuhkan, tanyakan terlebih dahulu apakah data yang sudah kami miliki benar benar layak dipakai. Mulai dari kelengkapan, akurasi, keterwakilan, konsistensi, dan transparansi asal usulnya.
Daftar Pustaka
- Inclusion Cloud, Data Governance, Ensuring Data Quality and Overcoming Data Bias, https://inclusioncloud.com/insights/blog/data-governance-data-bias/
- Liu, G., Data Quality Problems Troubling Business and Financial Researchers, A Literature Review and Synthetic Analysis, Journal of Business and Finance Librarianship, West Chester University, https://digitalcommons.wcupa.edu/cgi/viewcontent.cgi?article=1013&context=lib_facpub
- Toucan Toco, How to Avoid Bias and Pitfall in Data Reporting, https://www.toucantoco.com/en/blog/avoid-bias-in-data-reporting
- Latif, S., Qayyum, A., Usama, M., Qadir, J., Zwitter, A., dan Shahzad, M., Caveat Emptor, the Risks of Using Big Data for Human Development, arXiv, https://arxiv.org/pdf/1905.00493
- Lovallo, D., dan Sibony, O., The Case for Behavioral Strategy, McKinsey Quarterly, https://www.mckinsey.com
- World Journal of Advanced Research and Reviews, The Impact of Data Bias on Decision Making, https://wjarr.com/sites/default/files/WJARR-2022-0453.pdf

 Google